SAP
データレイクとは?データウェアハウスとの違いと構築5ステップを解説
- SHARE


社内のデータ活用を進めると、基幹システムの数値だけでなく、ログ・画像・文書のように形式の決まっていないデータをどこへ貯めるかという問題に行き当たります。
データレイクとは、形式の決まっていないデータも含めて、あらゆるデータを貯めておける保管の仕組みです。
この記事では、データレイクの定義、データウェアハウス(DWH)との違いと使い分け、仕組み、構築の進め方、運用でつまずきやすい課題までを、AWSやMicrosoftなどの公開情報をもとに整理します。
※本記事は2026年9月24日時点の公開情報にもとづいています。
データレイクとは|あらゆるデータを生のまま貯める一元保管庫
データレイクとは、構造化・非構造化を問わずあらゆるデータを、加工せず生のままの形式で一元的に保存しておく大容量のデータ保管庫です。
AWSの公式ドキュメントでも「規模にかかわらず、すべての構造化データと非構造化データを保存できる一元化されたリポジトリ」と定義されています。
データレイクという言葉は、2010年に米Pentaho社の創業者James Dixon氏が提唱しました。
Dixon氏が、加工済みのデータを配るデータマートを「ボトル入りの水」、データレイクを「より自然な状態にある大きな水のかたまり」にたとえたことから、日本語では「データの湖」とも呼ばれます。
対象になるデータは次の3種類です。
- 構造化データ:基幹システムの取引記録のような、表形式で整理されたデータ
- 半構造化データ:JSONやログファイルのような、一定の形式は持つが表にはなっていないデータ
- 非構造化データ:画像・動画・音声・文書のような、決まった構造を持たないデータ
なぜ「生のまま」貯めるのか
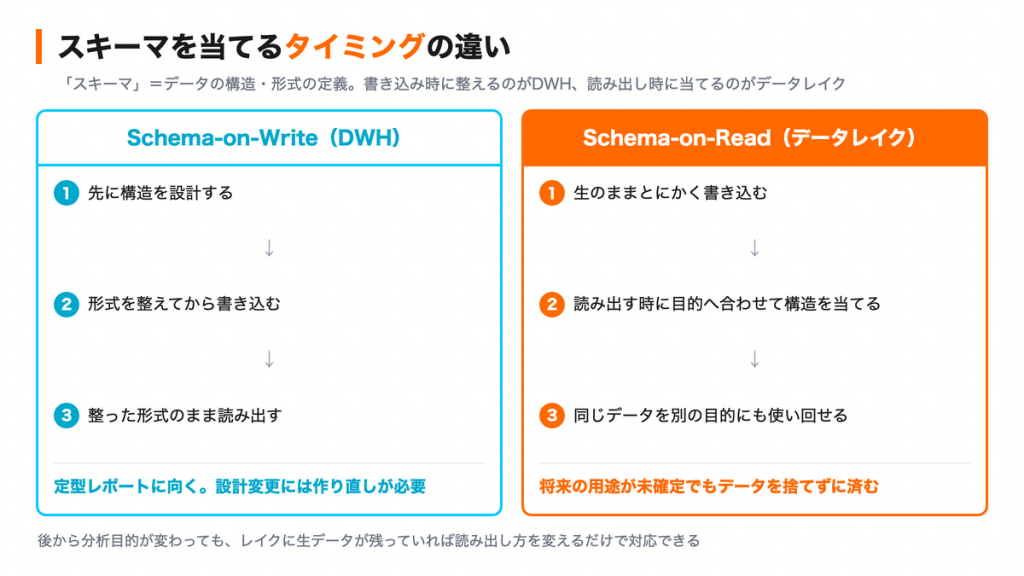
データレイクは、保存する時点では構造を決めず、読み出す時点で目的に合わせて構造を当てる方式を取ります(詳細は後述のSchema-on-Readをご覧ください)。
生のまま貯めることには、分析の目的が後から変わっても、元データを捨てずに済むというメリットがあります。
データレイクの主な活用シーン
代表的な使いどころは次の3つです。
- AI・機械学習の学習データ基盤
- 製造業では、設備の稼働ログや検査画像をそのまま貯めておき、故障の予兆を検知するモデルの学習に使う形が取られています。集計済みの数値では失われてしまう細かな変化が、生データには残っているためです。
- IoT・ログデータの蓄積
- センサーや機器から絶え間なく届くデータは、発生した時点では何に使うかが決まっていません。まずデータレイクへ貯めておき、分析したいテーマが決まった段階で必要な期間・項目を取り出す使い方ができます。
- 部門をまたいだ顧客データの統合
- 購買履歴、Webの行動ログ、問い合わせ内容は、それぞれ別のシステムに別の形式で入ったままの状態です。形式を問わず1か所へ集められるため、顧客ごとに行動を突き合わせた分析の土台になります。
関連記事:データドリブン経営とは?メリットや成功のポイント、注意点を解説
参考記事:AWS|データレイクとは
参考記事:James Dixon’s Blog|Pentaho, Hadoop, and Data Lakes
データレイクとデータウェアハウス(DWH)の違いと使い分け
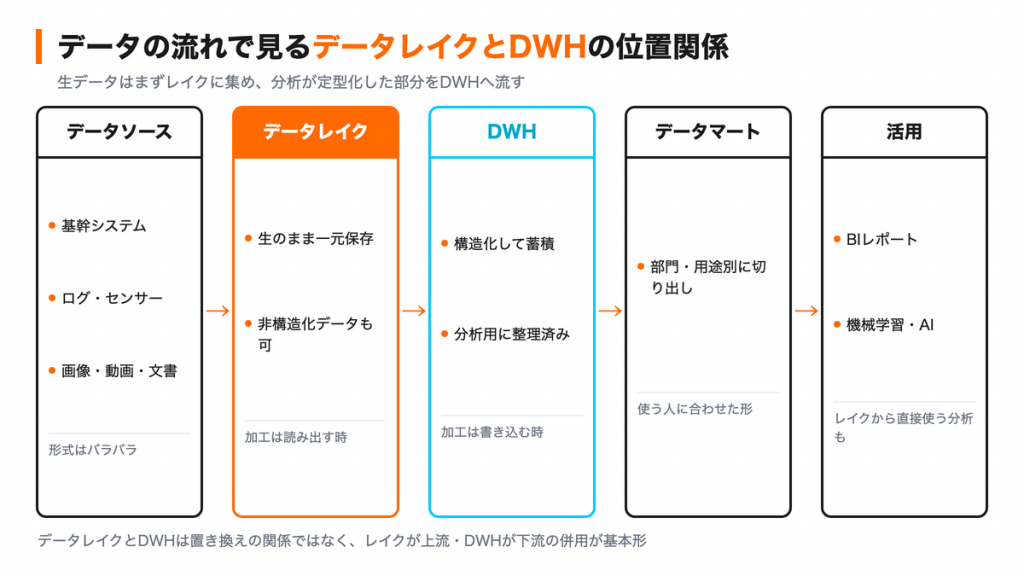
データレイクとDWHは、どちらか一方を選ぶ関係にはありません。
| 観点 | データレイク | データウェアハウス(DWH) |
|---|---|---|
| データの状態 | 生データ(加工前・非構造化を含む) | 整理・構造化済みのデータ |
| 構造を整えるタイミング | 読み出し時(Schema-on-Read) | 書き込み時(Schema-on-Write) |
| 主な用途 | 機械学習・探索的な分析 | 定型レポート・BI(データの集計・可視化ツール) |
| 主な利用者 | データサイエンティスト・エンジニア | 業務部門・経営層 |
表の違いはいずれも「構造をいつ整えるか」から生まれており、データレイク・DWH・データマート(部門や用途別にデータを切り出した層)を組み合わせた全体は「データ基盤」と呼ばれます。
どちらを選ぶかではなく、どう組み合わせるか
併用する場合は、生データをデータレイクに集め、定型レポートに使うデータを加工してDWHへ連携する構成が一例です。すでにDWHを運用している場合は、既存の構成や分析目的を確認したうえで、データレイクを追加するか検討します。
関連記事:データウェアハウスとは?構成要素と構築の進め方、製品の選び方まで解説
データレイクの仕組みとアーキテクチャ
基本構成は収集・蓄積・加工・活用の4層
データレイクの構成は、収集・蓄積・加工・活用の4つの層に分けて捉えると整理しやすくなります。
- 収集:基幹システム・ログ・ファイルサーバーなどからデータを取り込む
- 蓄積:取り込んだデータを生のまま保存する
- 加工:分析に使う分だけを整形・変換する
- 活用:BIツールでの可視化や機械学習に使う
蓄積の層には、オブジェクトストレージ(ファイルの形式を問わず保存できる保管領域)を使うのが一般的です。
さらに蓄積の中を、生データ(Raw)・整形済み(Cleansed)・利用向け(Curated)のように分ける「ゾーン設計」を行います。
どの状態のデータがどこにあるかを明確にするための設計です。
Schema-on-Readという考え方
スキーマとは、データの構造・形式の定義のことです。
DWHは書き込む前にスキーマを決め、形式を整えてから格納します(Schema-on-Write)。
データレイクでは生データを保持し、利用目的に応じて読み出し時にスキーマを適用できます(Schema-on-Read)。元データを残せるため、後から異なる目的の分析にも利用できます。ただし、データを探して安全に使えるようにするため、保存場所やメタデータ、アクセス権限の設計は必要です。
レイクハウスとSAP環境との接続
データレイクハウスとは、データレイクの柔軟さとDWHの管理機能を1つの基盤に統合したアーキテクチャです。米Databricks社が提唱した構成で、レイクとDWHを二重に持つ運用を簡素にする選択肢になります。
SAPシステムのデータを分析に使う場合は、SAP Business Data CloudなどのSAP製品を利用する方法や、既存の分析基盤と連携する方法があります。適した構成は、利用中のSAP製品、取り出したいデータ、分析目的によって異なります。連携方法や契約条件を含めて確認しましょう。
関連記事:1日に数億件発生するデータをリアルタイムに処理できるデータスフィアとは|DXの現場
データレイク構築の進め方5ステップ
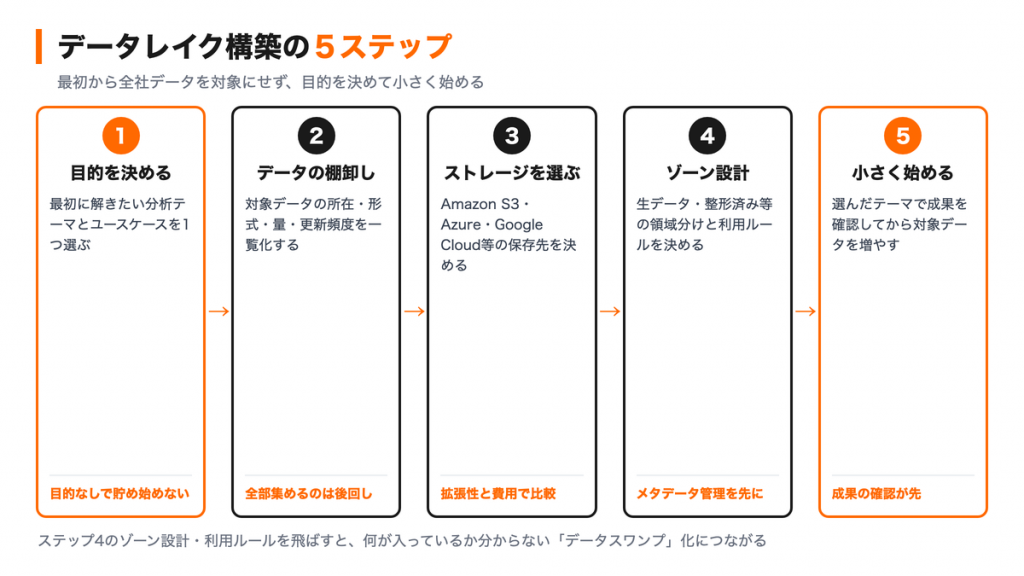
構築は次の5ステップで進めます。
- 目的とユースケースを決める:最初に解きたい分析テーマを1つ選ぶ。目的を決めずに貯め始めない
- 対象データを棚卸しする:所在・形式・量・更新頻度を一覧にする。全社データを最初から集めない
- ストレージを選ぶ:保存先のサービスを決める。特定サービスへの依存度とデータ転送の費用まで確認する
- ゾーンとルールを設計する:領域分けとアクセス権限、メタデータ(データの出どころ・内容を示す説明情報)の管理方法を決める。後回しにすると探せないデータが増える
- 小さく始めて広げる:選んだテーマで成果を確認してから対象データを増やす
構築に使う代表的なクラウドサービス
データレイクの保存先として使われている代表的なクラウドのオブジェクトストレージは次のとおりです。
| サービス名 | 提供元・概要 |
|---|---|
| Amazon S3 | AWSのオブジェクトストレージ。データレイクの保存先として利用されている |
| Azure Data Lake Storage | Microsoftの分析用途向けストレージ |
| Google Cloud Storage | Googleのオブジェクトストレージ。同社の分析サービスと組み合わせて使われる |
オンプレミス(自社で保有する設備での運用)でも構築は可能ですが、容量を後から増やしやすく初期費用を抑えられることから、クラウドが広く選ばれています。
データレイクの課題と対策|構築時の注意点とデータスワンプを防ぐ運用
データレイクは貯めるだけなら手軽に始められる分、管理を後回しにすると使えない状態に陥りやすくなります。
構築時の注意点と代表的な課題
構築時の注意点は前章の5ステップに沿って示したとおりで、運用に入ってからの課題は次の4つです。
- データスワンプ化:何のデータか分からないまま貯まり続け、探せず信頼もできない「データの沼」になる
- ガバナンスの不足:アクセス権限や個人情報の扱いが曖昧なまま利用が広がる
- コストの膨張:従量課金のため、不要なデータや重複データを貯め続けると保存・処理の費用が増え続ける
- 運用体制の不在:データの管理責任者が決まらず、品質が放置される
課題への対策
対策の中心は、データを貯める前の取り決めです。
- メタデータ管理とデータカタログ(データの目録)の整備を最初に行う
- データごとの管理責任者と利用ルールを決めてから受け入れる
- 保存期間と削除の基準を決め、費用を定期的に点検する
体制やルールの整備は、部門ごとにデータが分断される「サイロ化」の解消と同じ考え方で進められます。
関連記事:サイロ化とは?原因や解消した事例をわかりやすく解説
参考記事:AWS|データレイクとは
データレイクを構築するならノムラシステムコーポレーション
データレイクの構築では、活用目的を絞って小さく検証し、保存領域の分け方やメタデータ、アクセス権限を設計することが重要です。既存のDWHとの連携方法は、現在のシステム構成に応じて検討します。
導入で判断が難しくなるのは、基幹システムのデータをどこまで、どの形で外に出すかを決める場面です。
SAP環境では、取り出すデータの範囲によって連携方法もライセンスの扱いも変わるため、分析したいテーマと現行の構成を突き合わせた設計が前提になります。
当社の強みは、SAPの導入と運用、経営管理のレポート設計で積み上げた知見です。SAPデータと分析基盤の連携構成について、現行システムと分析目的を踏まえてご相談いただけます。
分析したいテーマ、対象データの所在、現在のSAP環境の構成をお持ちいただければ、構想段階からご相談いただけます。
データレイクに関するよくある質問
Q1. データレイクの構築費用はどのように決まりますか?
保存容量に応じた従量課金と、データの処理・転送にかかる費用が中心です。
金額は容量・利用リージョン・アクセス頻度といった条件で変わり、アクセスの少ないデータを安価な保存階層へ移すと抑えられるため、対象データの棚卸しをしてから見積もる必要があります。
Q2. 中堅・中小企業にもデータレイクは必要ですか?
データ量と分析ニーズによります。
まず既存のデータベースやDWHの延長で足りるかを点検し、画像・ログのような非構造化データを活用したくなった時点で検討する順番が現実的です。
部門をまたいでデータを突き合わせたい場面や、AI活用の計画が出てきた段階が検討の始めどきになります。
Q3. SAPシステムのデータもデータレイクに統合できますか?
SAPシステムのデータも分析基盤と連携できます。
SAP Business Data Cloudなどを利用する方法や、既存のデータレイクと連携する方法があります。適した方法は、利用中のSAP製品、対象データ、分析目的、契約条件によって異なるため、個別に確認が必要です。
東京MXの番組で、ノムラシステムコーポレーションが取り上げられました。詳しい内容を知りたい方は、ぜひ下記のYouTube動画をご覧ください。
ノムラシステムコーポレーションの紹介動画
お問い合わせはこちら